别再死记 grep 参数了:搞懂一个原理,选项全串起来
前言
常见的 grep 教程大多按参数逐个罗列作用和场景,读完记住几个,换个场景又不会用了。本文换一个角度:先讲清 grep 的工作原理,即对每一行,用模式判断,匹配就打印;再把每个选项放回这个流程,看它调整的是哪一步。原理理解了,选项就不用死记,遇到没见过的选项,查 man page 时也能很快明白它的作用。
一、工作原理与基本格式
1.1 先从名字说起:g/re/p
grep 这个名字来自 Unix 早期的文本编辑器 ed 中的一条命令 g/re/p。这条命令由三部分组成:g 是 global,表示对所有行操作;re 是 regular expression,代表要匹配的正则表达式;p 是 print,表示把匹配的行打印出来。
比如在 ed 中输入 g/error/p,就会打印出所有包含 error 的行。这条命令用得太频繁,后来就被单独做成了一个程序,名字就叫 grep。
这三部分就是 grep 的全部工作原理:对输入的每一行,用模式判断,匹配就打印。
这里的模式,简单说就是”要查找的内容”,比如 grep 'error' app.log 中的 error。更准确的含义见 1.6 节。
选项是以 - 开头的开关,用来改变 grep 的默认做法。比如 -i 让”判断”这一步不区分大小写,-n 让”打印”这一步带上行号,详见 1.5 节。后面讲的所有选项,都是在调整这几步中的某一步,对应关系见 1.8 节。
1.2 工作原理:逐行判断
把 1.1 节的 g/re/p 展开来说:grep 把输入一行一行地拿出来,判断这一行是否匹配模式,匹配就输出(默认输出整行),不匹配就丢弃。官方手册也明确说明,grep 从根本上是按行工作的。
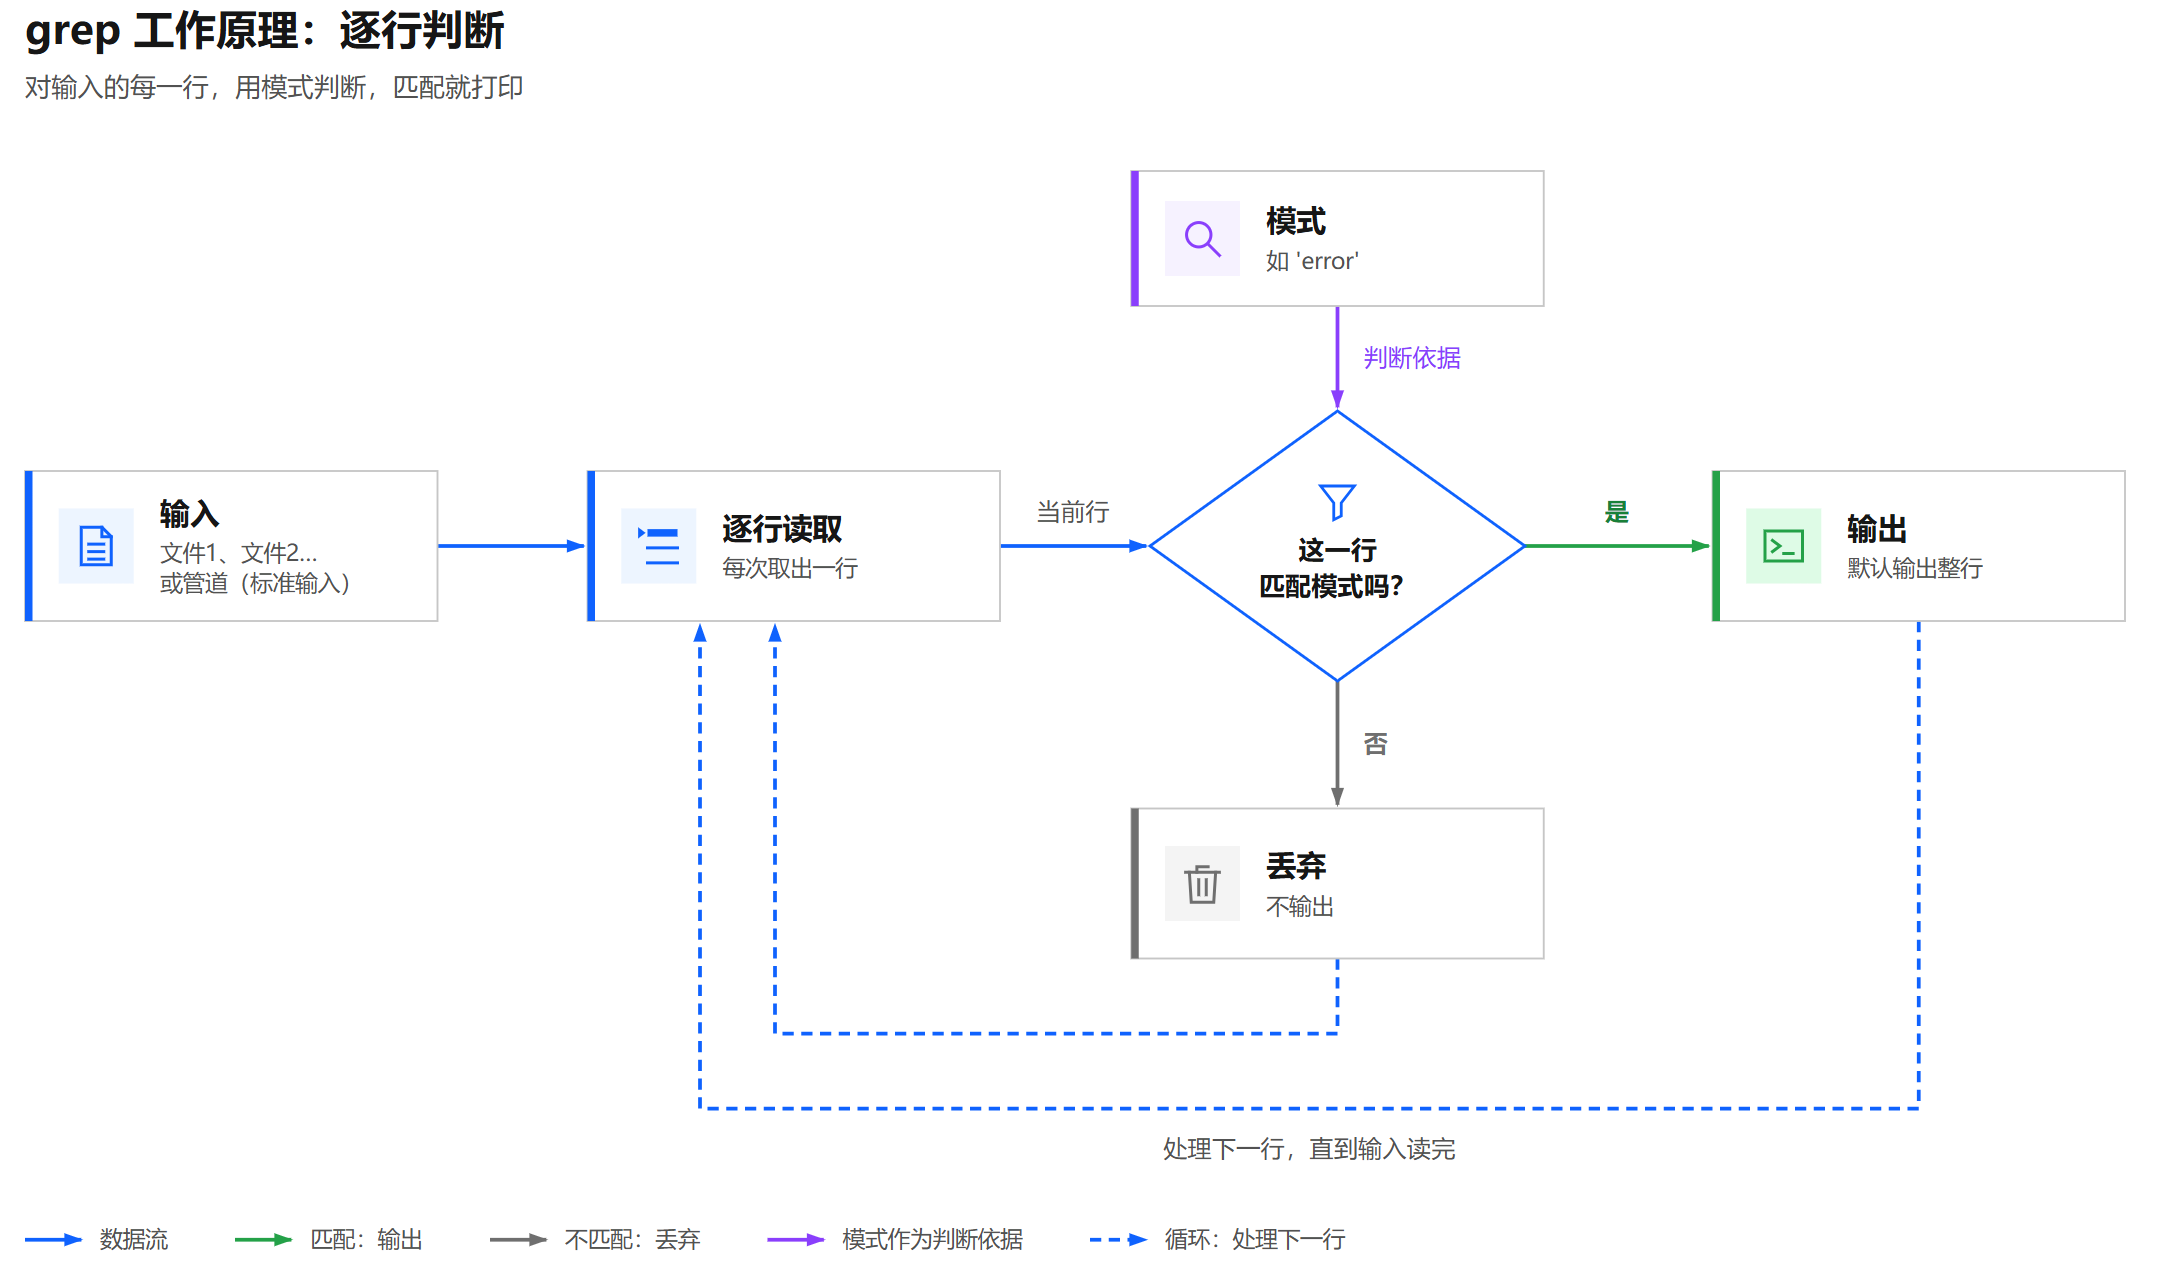
理解这一点,很多行为就自然明白了:
输出的单位默认是整行。 因为判断的单位是行,所以模式只匹配到一个词,输出的也是这个词所在的整行。
一行里出现多次也只算一行。 每行只判断一次”匹配或不匹配”,这就是 -c 统计行数而不是次数的原因。
多个文件只是输入变多。 判断逻辑完全一样,只是输出时加上文件名来区分来源。
grep 无法跨行匹配。 想找”A 这一行的下一行是 B”,grep 做不到,只能用 -A 显示上下文后人工查看,或者改用 awk、sed 等工具。
grep 结束时还会返回一个退出码:0 表示找到了匹配,1 表示没找到,2 表示出错(如文件不存在)。执行后用 echo $? 可以查看,脚本中常用它做判断。
1.3 官方命令格式
man grep 的格式(SYNOPSIS)部分列出了三种写法,区别只在于模式从哪里来:
1 | grep [OPTION...] PATTERNS [FILE...] |
对应的中文:
1 | grep [选项...] 模式 [文件...] # 模式直接写在选项后面 |
读格式时注意两个符号:方括号 [] 表示可以省略,... 表示可以有多个。
三种写法的关系: -e 和 -f 本身是普通选项,和 -i、-v 一样属于”匹配控制”类。和 -A 3 一样,它们是带值的选项,后面必须紧跟一个值:-e 后面紧跟的值就是模式,例如 -e 'error' 中的 error;-f 后面紧跟的值是一个文件名,这个文件里每行写一个模式。官方把它们单独列成两种写法,是因为模式已经作为它们的值给出了,命令里就不再需要单独写模式,剩下的内容全部当作文件。所以第一种写法只在没有 -e、-f 时适用。至于什么时候需要用 -e、-f,见第三节。
日常用得最多的是第一种写法。从这种写法可以看出:
| 组成部分 | 数量 | 说明 |
|---|---|---|
| 选项 OPTION | 0 个或多个 | 不写就按默认规则工作 |
| 模式 PATTERNS | 1 个 | 不能省略。注意官方用的是复数:一个模式参数里可以包含多个模式(用换行分隔) |
| 文件 FILE | 0 个或多个 | 不写就从标准输入(管道)读 |
注:RHEL 7 的 grep 2.20 的 man page 中写的是单数 PATTERN,含义相同,新版本改成复数是为了强调”一个参数可以装多个模式”。
1.4 拆开看:grep 怎样区分选项、模式、文件
在 shell 中输入一行命令后,shell 先按空格把它切成一个个”单词”,再交给 grep。grep 拿到这些单词后,按下面的规则分类:
- 以
-开头的是选项(遇到--后,后面的一律不再当选项)。 - 带值的选项会取走紧跟在后面的一个单词,作为自己的值,如
-A 3中的3、-e 'a'中的a。 - **剩下的叫”操作数”**(帮助原文英文就叫operand,意思是命令要处理的对象,也就是模式和文件)。如果模式已经作为
-e或-f的值给出,所有操作数都是文件;否则第一个操作数是模式,其余是文件。
以 grep -n -i 'error' app.log sys.log 为例:
| 单词 | 类别 | 作用 |
|---|---|---|
-n |
选项 | 输出时显示行号 |
-i |
选项 | 匹配时忽略大小写 |
'error' |
模式(第一个操作数) | 要找的内容 |
app.log |
文件 | 第一个输入 |
sys.log |
文件 | 第二个输入 |
以 grep -e 'a' 'b' file 为例:
| 单词 | 类别 | 作用 |
|---|---|---|
-e |
选项 | 表示后面紧跟的值是模式 |
'a' |
-e 的值 |
模式 |
'b' |
操作数 | 文件(因为模式已由 -e 的值给出) |
file |
操作数 | 文件 |
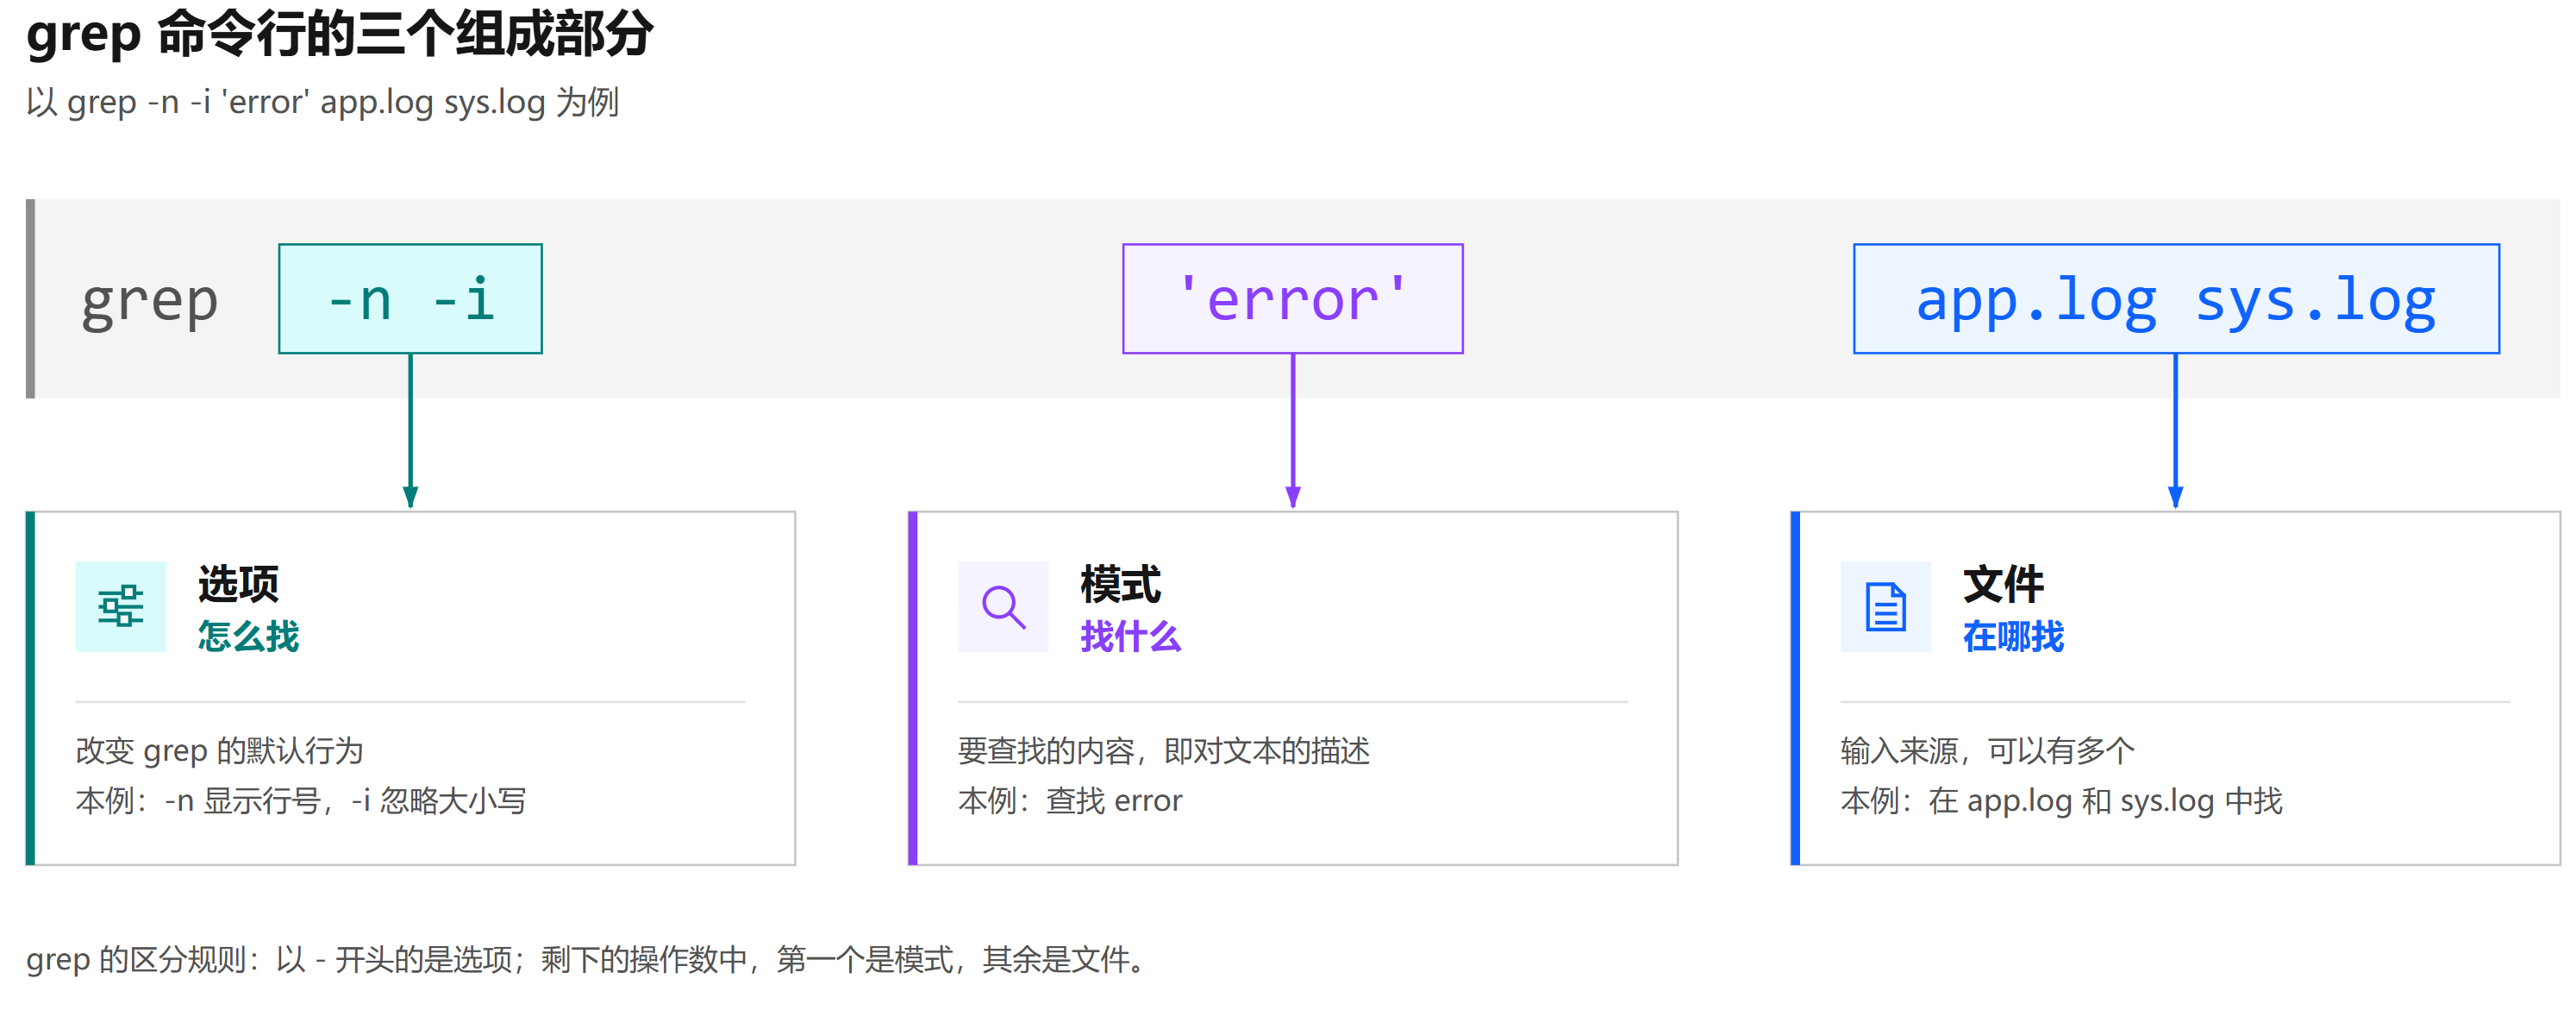
这个规则直接解释了两个常见现象:
模式以 - 开头时会被误当成选项。 比如想在 file 文件中查找 -l 这个内容,写成 grep -l file,或者哪怕写成grep '-l' file。按规则 1,grep 把 -l 当成”只列出文件名”的选项;于是 file 成了第一个操作数,被当作模式;后面没有文件,grep 就转去等待标准输入,表现为命令卡住不动(按 Ctrl+C 退出)。
正确写法是 grep -e '-l' file,让 -l 作为 -e 的值;或者写成 grep -- '-l' file,用 -- 结束选项(见第三节)。
用了 -e 后,剩下的操作数全部被当成文件。 比如想在 file 文件中同时查找 a 和 b,写成 grep -e 'a' 'b' file。按上面的拆解表,只有 a 是模式,b 被当成了文件,所以 grep 实际是在 b 和 file 两个文件中找 a,并报错 grep: b: No such file or directory。正确写法是每个模式各用一个 -e:grep -e 'a' -e 'b' file。
1.5 选项:改变 grep 的默认行为
选项是以 - 开头的参数,作用是告诉 grep “不要按默认方式做”。不加任何选项时,grep 的默认行为是:模式按基本正则(BRE)解释、区分大小写、行内包含即算匹配、输出整行、搜一个文件时不显示文件名。每个选项改变其中的某一项。
选项有以下几种写法:
| 写法 | 例子 | 说明 |
|---|---|---|
| 短选项 | -i |
一个减号加一个字母,日常最常用 |
| 长选项 | --ignore-case |
两个减号加单词,与 -i 完全等价;写在脚本里更易读(长选项是 GNU 扩展) |
| 合并短选项 | -ni |
等于 -n -i,顺序无关 |
| 带值的短选项 | -A 3 或 -A3 |
选项后面必须跟一个值 |
| 带值的长选项 | --after-context=3 |
用等号连接值 |
常用选项的长短对照:-i 即 --ignore-case,-v 即 --invert-match,-w 即 --word-regexp,-x 即 --line-regexp,-n 即 --line-number,-c 即 --count,-r 即 --recursive,-e 即 --regexp。
关于选项的位置:POSIX 规定选项要写在模式和文件之前。GNU grep 更宽松,grep 'error' app.log -n 也能正常工作,因为它会把后面的选项挪到前面处理。但为了习惯统一、换系统不出错,建议始终把选项写在最前面。
1.6 模式:描述”要找的文本长什么样”
为什么叫”模式”,而不叫”查找内容”? 因为 grep 拿到的不一定是一段固定的文字,往往是一条描述,说明要找的文本”长什么样”。”模式”(pattern)的本义是样式、模板,就像服装的版型,按一个版型能裁出许多件衣服;一个模式也能同时对上许多段不同的文本。叫”查找内容”,就暗示只能找一段确定的文字,概括不了”一条描述对应一类文本”这个能力。官方手册把 grep 称为模式匹配引擎,把正则表达式定义为”描述一组字符串的模式”,用的都是这个含义。
| 模式 | 相当于在说 | 能匹配到的具体文本 |
|---|---|---|
error |
找 error 这个词 | 只有 error |
ERR[0-9] |
找 ERR 后面跟一个数字 | ERR1、ERR5、ERR9…… |
^root: |
找行首是 root: 的 | root:x:0:0:root:/root:/bin/bash |
err.*ed |
找 err 开头、ed 结尾的 | erred、error occurred…… |
所以,模式写成普通文字时,它就是查找内容本身,这是最简单的情况;模式里用了正则符号时,它是一条规则,凡是符合规则的文本都算找到。
不加 -E/-F/-P 时,grep 按基本正则(BRE)理解模式;
加 -F 时,grep 不解释任何正则符号,模式就严格等于查找内容。
加 -P 时,按 Perl 风格的正则理解,支持 \d 等更丰富的写法,但它是 GNU grep 独有的功能,换到其他系统可能不支持,日常一般用不到。这几种模式的区别和选择见第四节。
关于模式,还有以下几点要注意:
模式和行比较,不是和文件名比较。 grep 拿模式去逐行比对文件的内容。筛选文件名用的是 --include 等选项,而且那里用的是 shell 通配符,和模式的语法不同(见第七节)。官方手册也专门提醒:模式的正则语法与 shell 匹配文件名的通配符语法是两回事。
“匹配”指的是行中有一段符合模式。 只要一行里有任何一段文字符合模式,整行就算匹配。所以默认是”包含即可”的子串匹配,第二节的 -w、-x 就是在收紧这个标准。
模式可以有多个,它们是”或”的关系。 用多个 -e、用 -f 读文件、或在一个模式参数里换行分隔,效果都是”符合任意一个就算匹配”。
模式要用单引号包起来。 shell 会先处理命令行再交给 grep,模式里的 *、?、[]、$ 等可能被 shell 提前替换。单引号能保证 grep 收到的就是你写的内容,官方手册也建议在 shell 中给模式加引号。
模式以 - 开头时,用 -e 或 -- 保护。 比如要查找 -l、--size 这类内容,直接写会被当成选项(原因见 1.4 节)。写成 grep -e '-l' file 或 grep -- '-l' file 即可。官方 man page 介绍 -e 时也专门提到,它可以用来保护以 - 开头的模式。在命令帮助中查找某个选项时经常用到,例如 lvextend --help | grep -e '-L'。
1.7 文件:从哪里读输入
文件是 grep 的输入来源,有以下几种情况:
| 写法 | grep 的行为 |
|---|---|
一个文件 grep 'x' a.log |
只搜这个文件,输出不带文件名 |
多个文件 grep 'x' a.log b.log |
逐个搜索,每行输出前加 文件名:,以便区分来源 |
通配符 grep 'x' *.log |
shell 先把 *.log 展开成多个文件名,对 grep 来说就是”多个文件” |
不写文件 cat a.log | grep 'x' |
从标准输入(管道)读取 |
不写文件但加 -r |
搜索当前目录 . 下的所有文件 |
文件名写 - |
代表标准输入,可以和普通文件混用:cat a.log | grep 'x' - b.log |
1.8 选项作用在流程的哪一步
官方手册把选项按作用分成几类,正好对应 g/re/p 流程中的各步。本文后面各节也按这个思路组织:
| 流程步骤 | 官方分类 | 本文涉及的选项 | 本文章节 |
|---|---|---|---|
| 读取输入(从哪找) | 文件和目录选择 | -r -R --include --exclude |
第七节 |
| 确定模式(找什么) | 匹配控制、匹配器选择 | -e -f;-E -F -P |
第三、四节 |
| 判断匹配(怎样算找到) | 匹配控制 | -i -w -x -v |
第二节 |
| 输出结果(输出什么) | 通用输出控制、行前缀控制、上下文控制 | -c -o -l --color;-n;-A -B -C |
第五、六、七节 |
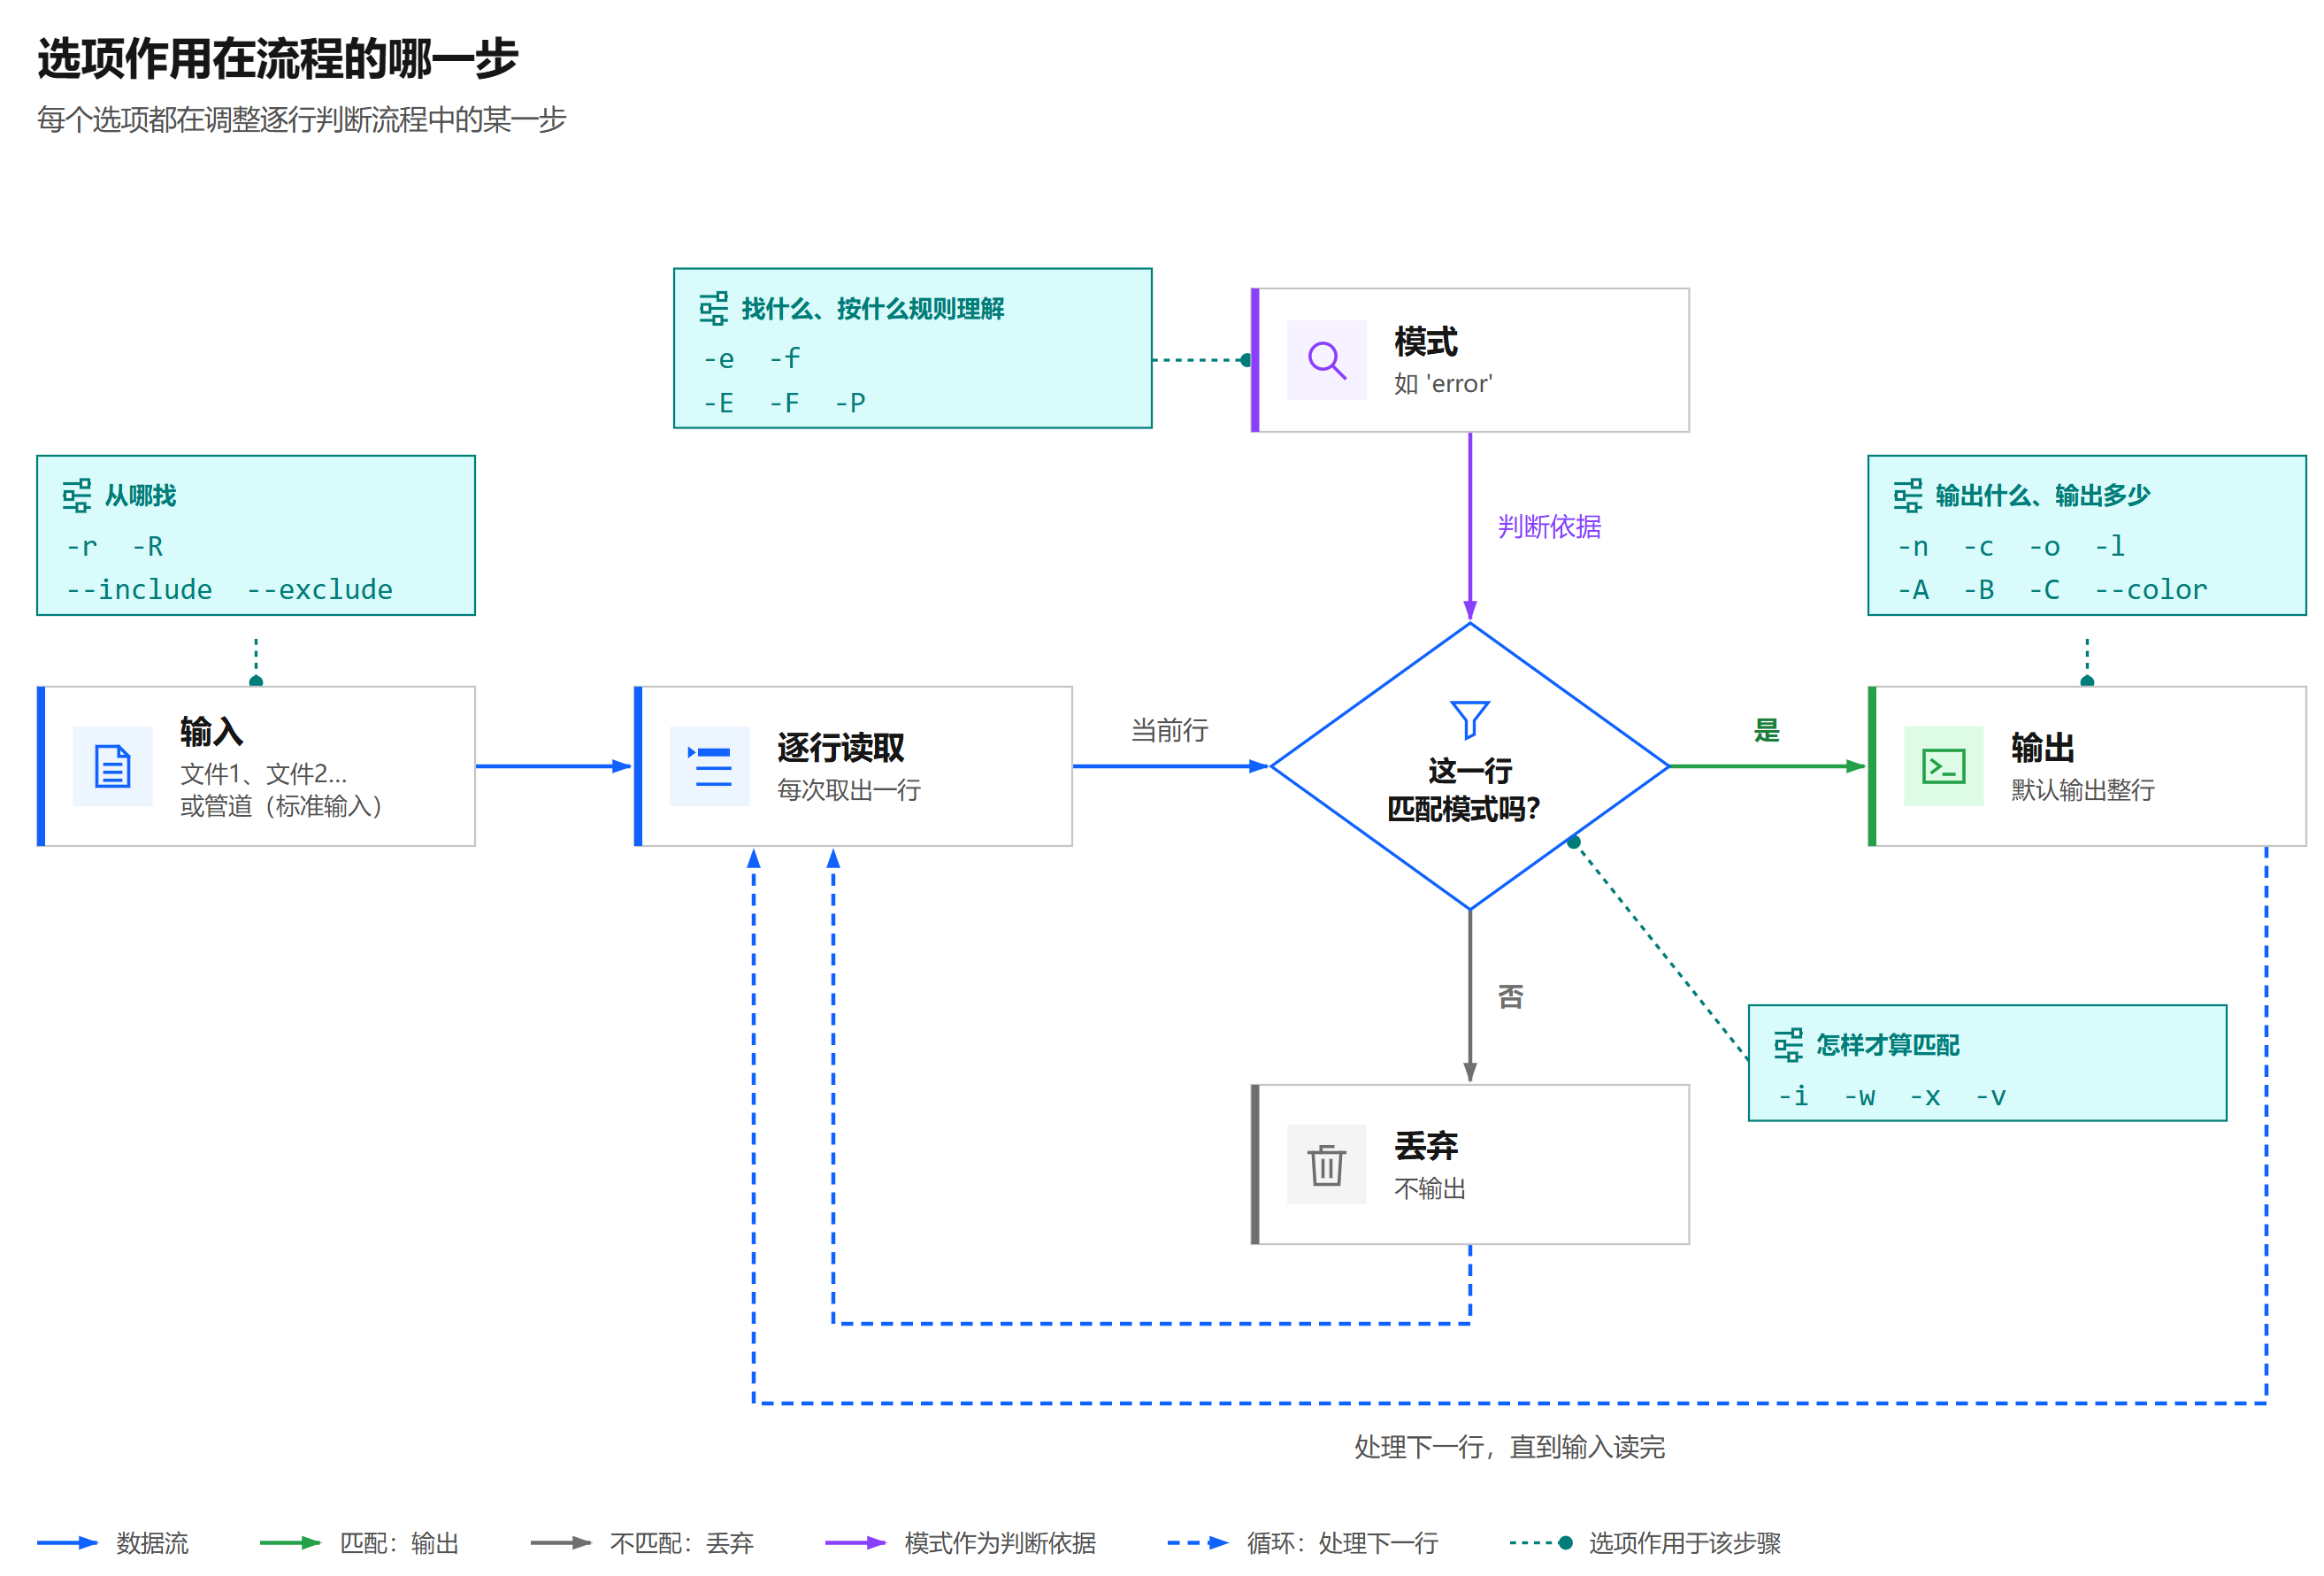
二、控制匹配范围:-i、-w、-x、-v
模式是”找什么”,比如 root。但一行中出现了 root 就一定算匹配吗?Root 算不算?chroot 算不算?这就是匹配范围要回答的问题:同一个模式,用不同选项可以放宽或收紧”算匹配”的标准。
默认规则是:区分大小写、子串匹配(见 1.6 节),即行内只要出现这几个连续字符(大小写完全一致)就算匹配。
-i:忽略大小写
grep 默认区分大小写,加 -i 才不区分。这是放宽标准。
1 | printf 'Error\nerror\nERROR\n' > /tmp/case.txt # 准备三行,大小写各不相同 |
-w:整词匹配
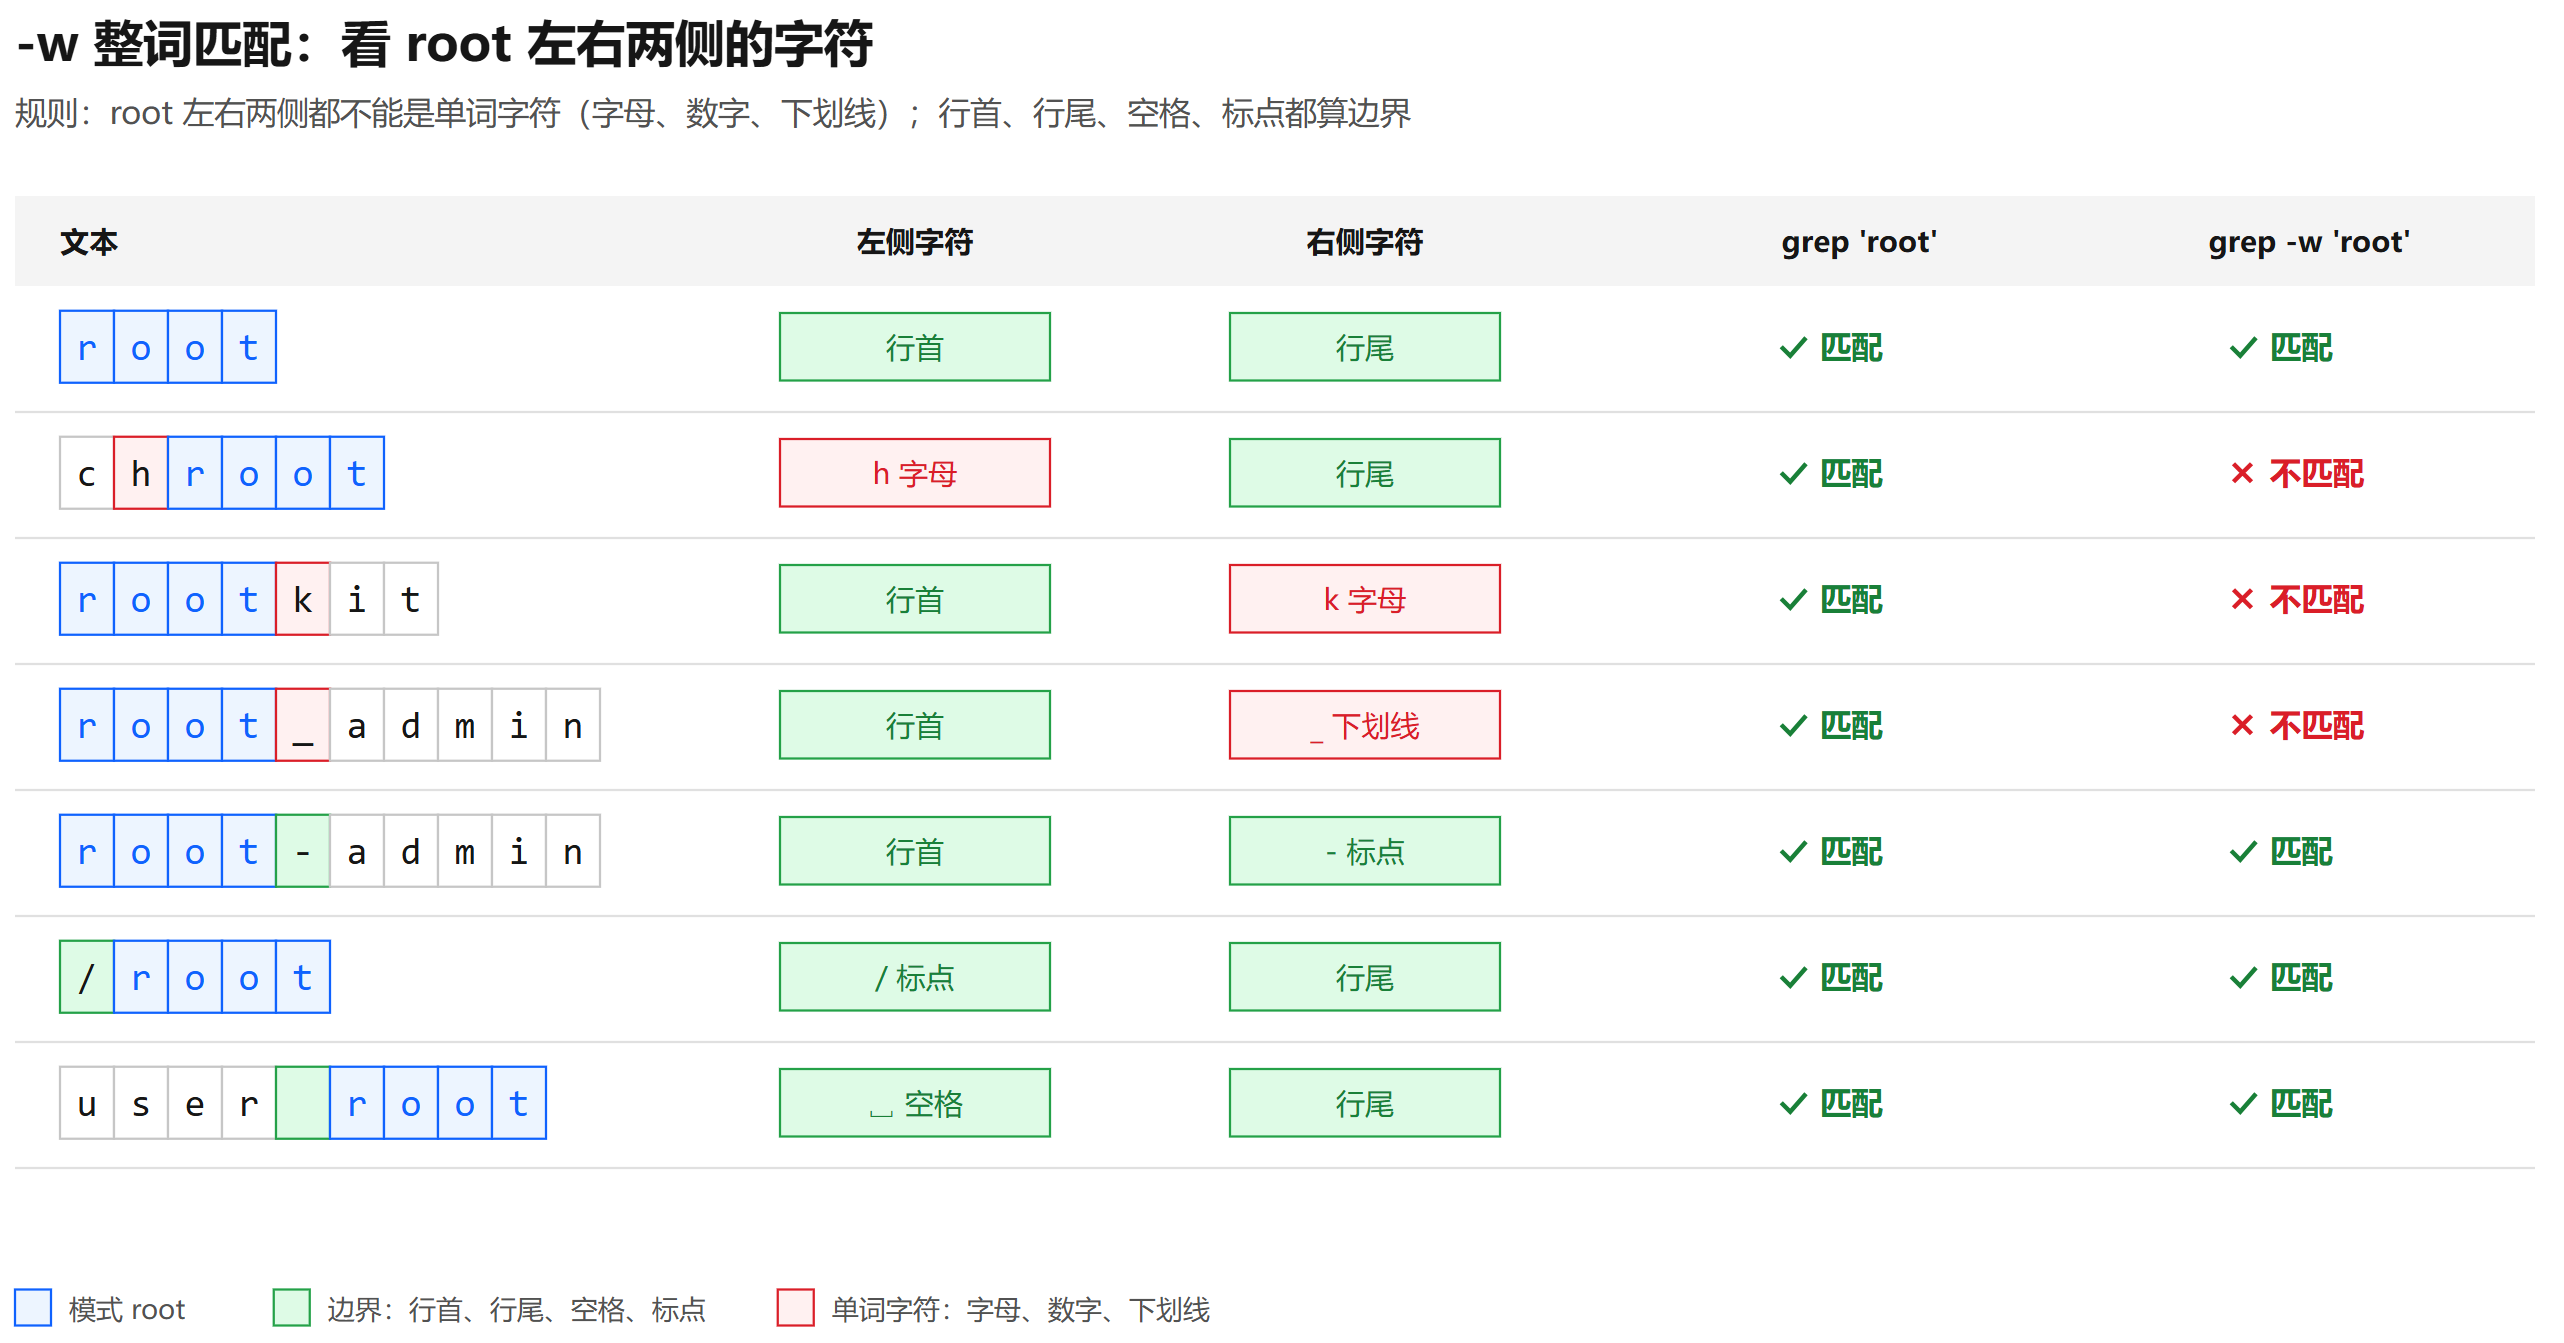
不加 -w 时是子串匹配,不管前后挨着什么。加了 -w 后,要求匹配内容的**左右两边都不是”单词字符”**。这是收紧标准。
单词字符只有三类:字母、数字、下划线。行首、行尾、空格、标点(: / - . 等)都算边界。所以”多一个字符就不算”只对了一半:多一个字母、数字或下划线才不算,多一个标点照样算。
1 | printf '%s\n' root chroot rootkit root_admin root-admin /root 'user root' > /tmp/t.txt |
chroot、rootkit、root_admin 被排除,因为 root 紧挨着字母或下划线。root-admin 仍然匹配,因为 - 是边界,这一点最容易让人意外。
实际例子: 在 RHEL 上执行 grep -w root /etc/passwd,通常输出两行:
1 | root:x:0:0:root:/root:/bin/bash |
operator 也出现了,因为它的家目录 /root 被 / 和 : 夹着,满足整词条件。所以 -w 做不到”只找 root 用户”。真正精确的写法是按文件结构写正则:用户名在行首,后面跟冒号。
1 | grep '^root:' /etc/passwd |
结论:-w 适合快速排除”嵌在别的单词里”的情况;要精确定位,结合 ^、$、分隔符写更具体的正则。
-x:整行匹配
要求整行完全等于模式,这才是”多一个字符都不行”。这是最严格的标准。
| 写法 | 含义 | 等价正则 |
|---|---|---|
grep 'root' |
行内包含 root 即可 | root |
grep -w 'root' |
root 作为独立的词出现 | \broot\b |
grep -x 'root' |
整行就是 root | ^root$ |
-v:反向匹配
把判断结果反过来:输出不匹配的行,丢弃匹配的行。日常使用频率很高。
1 | grep -v '^#' /etc/fstab # 去掉注释行 |
-v 可以和其他选项叠加,例如 grep -vi 'debug' 表示去掉所有大小写形式的 debug 行。
三、同时查找多个内容:-e、|、[]
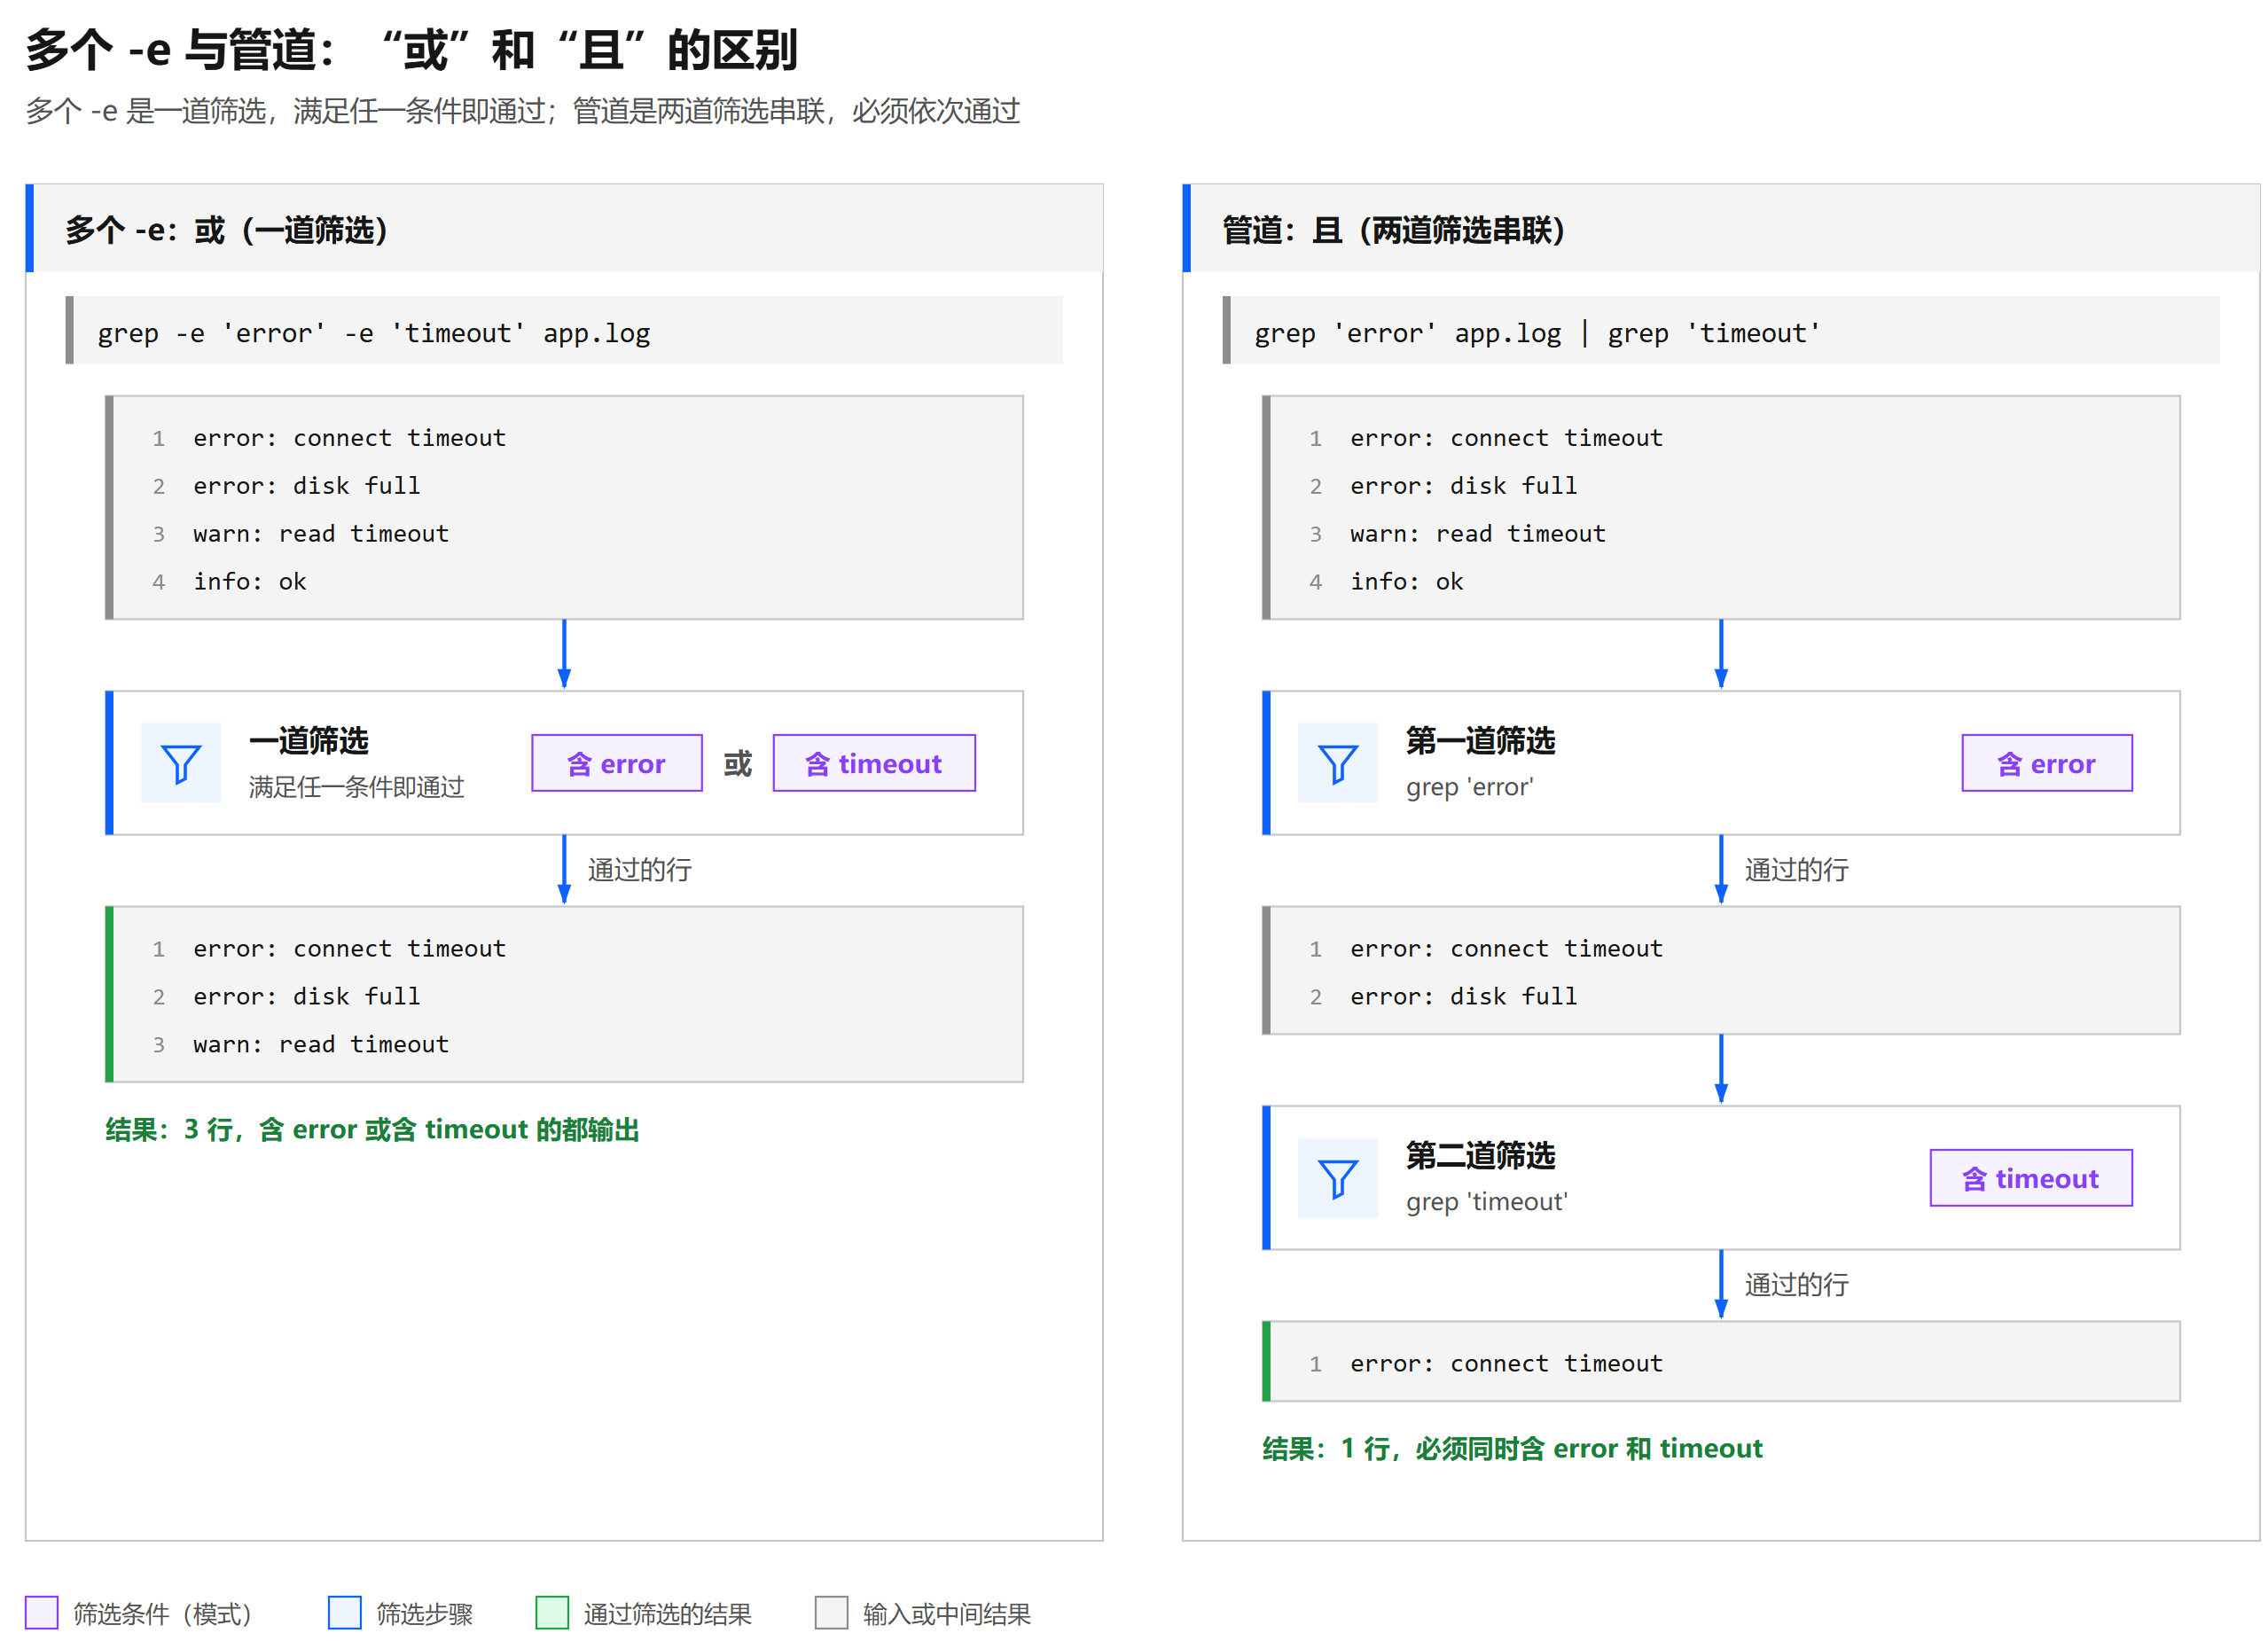
以 lvextend --help 为例:输出中同时有 -l|--extents(按 PE 个数扩容)和 -L|--size(按容量扩容),要把两者都找出来。
先避开一个坑:模式以 - 开头
按第一节的规则,以 - 开头的内容会被当成选项。直接写 grep -l,grep 会把 -l 当成自己的选项(”只列出文件名”),而不是要搜的模式。解决办法有两个:用 -e 明确声明”后面是模式”,或用 -- 表示”选项到此结束”。
四种写法
1 | # 写法一:多个 -e,每个 -e 跟一个模式(最直观,推荐) |
多个 -e 是”或”的关系,与书写顺序无关。 写成 -e '-l' -e '-L' 还是 -e '-L' -e '-l',结果完全一样。grep 是逐行判断的(1.2 节),每读一行,就拿所有模式一起去比:只要符合其中任意一个,这一行就输出;同时符合多个,也只输出一次。输出顺序跟着文件的行序走,不跟着 -e 的顺序走。
[lL] 和 -i 有什么区别? [lL] 的意思是”这个位置可以是 l,也可以是 L”,只管方括号所在的这一个字符;-i 则让模式中的每个字母都不区分大小写。本例的模式只有 l 这一个字母,所以写法三、四效果相同。
模式一长,区别就出来了。比如要找 error 和 Error,但不想要全大写的 ERROR:
1 | grep '[eE]rror' file # 只匹配 error、Error |
[eE] 只放开了首字母,其余字母仍要严格小写;-i 则全部放开。所以 [] 能精确指定”哪个位置、可以是哪些字符”。
反过来,-i 只能让同一个字母的大小写互相匹配。要同时找 -l 和 -r,-i 就无能为力了,因为 l 无论大写还是小写都变不成 r。这时只能用写法一、二,或者写成 -[lr],即”这个位置是 l 或 r”。
再精确一点:加 -w
实际运行会发现,-l 还会匹配到 --lockopt 这类长选项,因为里面也含有 -l 两个字符。加 -w 后,-l 后面紧跟字母的情况被排除(原理见第二节):
1 | lvextend --help | grep -w -e '-l' -e '-L' |
“且”的关系用管道
-e 和 | 都是”或”。要求一行里同时包含 A 和 B,grep 没有直接的选项,用管道串联:第一个 grep 筛出含 A 的行,第二个 grep 再从中筛出含 B 的行。
1 | grep 'error' app.log | grep 'timeout' |
模式很多时:-f
把模式逐行写进文件,用 -f 读取,适合批量查找一组 IP 或用户名:
1 | grep -F -f iplist.txt access.log |
怎么选
用正则的”或”(grep -E 'a|b')和用多个 -e,匹配结果一样,各有适合的场景。
正则”或”的优势是能提取共同部分,这是多个 -e 做不到的。比如要找 error 和 errors,可以写成 'errors?';要找 -l 和 -L,可以写成 '-[lL]'。几个模式长得相似时,正则写起来最简洁。
但有三种情况,用多个 -e 或 -f 更合适:
- 搜纯文本时。
-F不解释任何正则符号,|也只是普通字符,所以grep -F '10.0.0.1|10.0.0.2'找的是这一整串字面内容。要用-F搜多个 IP,只能写成grep -F -e '10.0.0.1' -e '10.0.0.2'。 - 带锚点时,正则”或”容易写错优先级。 比如想找以 root 或 bin 开头的行,写成
grep -E '^root|bin'是错的:^只作用于 root,实际意思是”以 root 开头,或者任意位置含 bin”。正确写法是'^(root|bin)'。用-e '^root' -e '^bin',每个模式各自独立,就不会有这个问题。 - 模式很多时。 几十上百个 IP 或用户名,写进文件用
-f读取,比一长串|更好维护。
| 场景 | 推荐写法 |
|---|---|
| 两三个模式,长得相似或较短 | grep -E 'a|b',能提取共同部分就提取 |
| 纯文本(IP、域名等带点的内容) | grep -F -e 'a' -e 'b' |
模式带 ^、$ 等锚点,或以 - 开头 |
多个 -e,每个独立写 |
| 模式很多 | grep -F -f 文件 |
四、正则:建议习惯用 -E
grep 的模式默认就是正则表达式,不是 shell 通配符。 最容易混淆的是 *:在 shell 里,* 单独就代表”任意内容”;在正则里,* 只表示”前一个字符重复 0 次或多次”,代表”任意一个字符”的是 .。所以正则里的”任意内容”要写成 .*,即”任意字符,重复任意次”。例如找”err 开头、ed 结尾”的内容,要写 err.*ed;如果按 shell 习惯写成 err*ed,它的意思就变成了”e,后面跟一串 r,再跟 ed”,error occurred 这样的行反而找不到。
grep 有四种模式写法:
| 选项 | 模式 | 何时用 |
|---|---|---|
| 不加 | 基本正则(BRE) | 默认值,读懂即可 |
-E |
扩展正则(ERE) | 日常首选 |
-F |
纯文本,不解释任何特殊字符 | 搜 IP、域名、版本号等带点的字符串 |
-P |
Perl 正则 | 少数需要 \d、\K 等高级写法的场合 |
-F:把模式当作纯文本
默认情况下,grep 会把模式里的 .、[]、*、$ 等当作正则符号来解释。加了 -F 后,grep 不解释任何特殊符号,模式写的是什么就找什么。
例一:查找 IP 地址
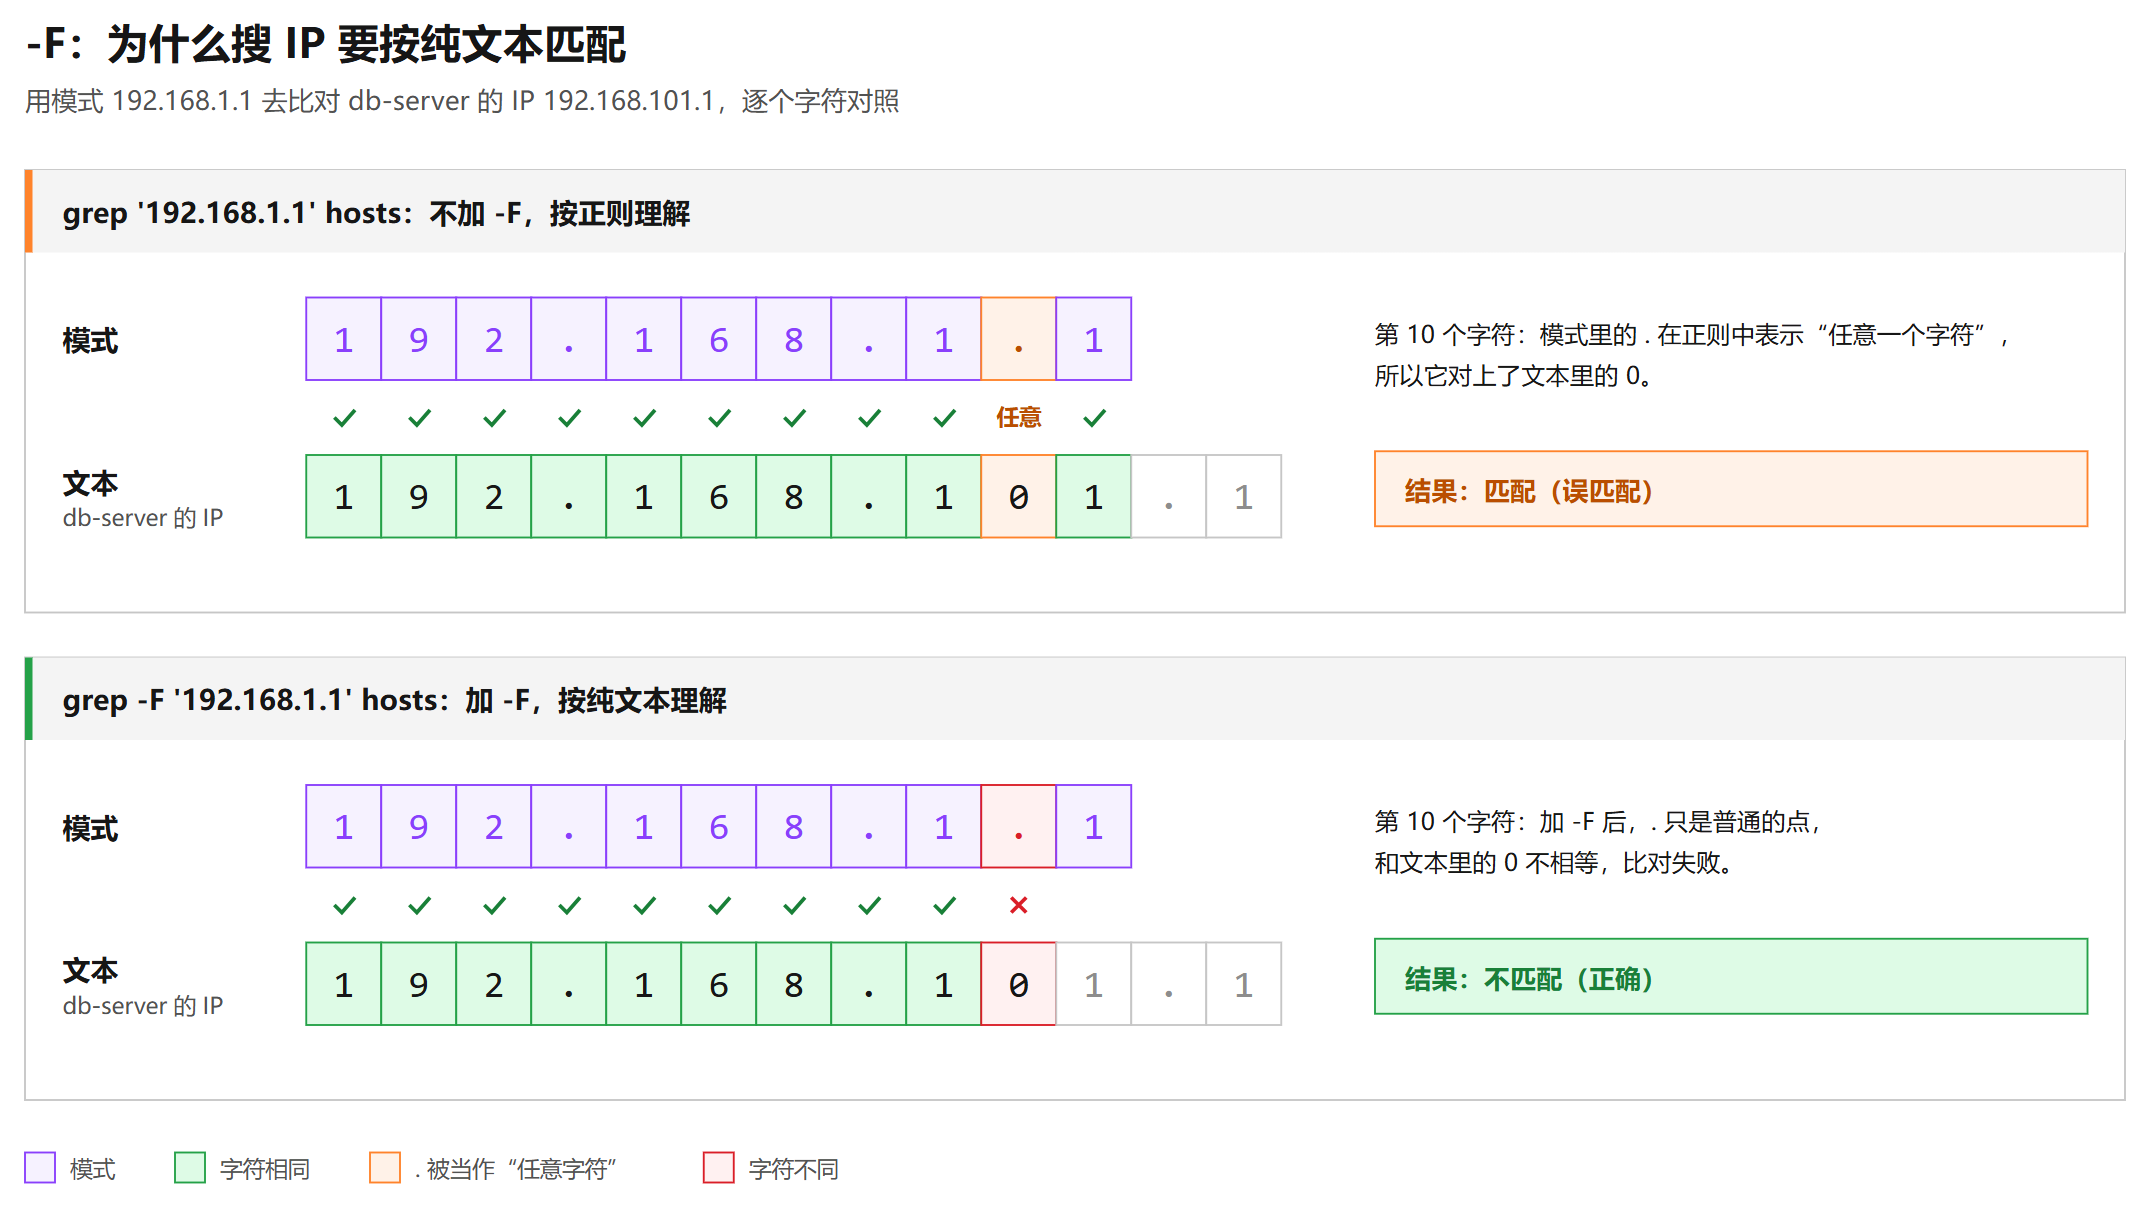
假设 hosts 文件中有这三行:
1 | 192.168.1.1 gateway |
想找网关 192.168.1.1:
1 | grep '192.168.1.1' hosts.txt |
结果三行全部输出,连 db-server 那行也出来了。原因是正则里的 . 表示”任意一个字符”。模式 192.168.1.1 中的第三个点,正好匹配上了 192.168.101.1 里的 0。
这种错误最危险。它不报错,结果看起来也合理,很容易被忽略。比如你据此去改配置,就可能误改了数据库服务器。
加上 -F 后,点只是普通的点:
1 | grep -F '192.168.1.1' hosts.txt |
1 | 192.168.1.1 gateway |
db-server 被排除了。剩下的 192.168.1.10 是因为默认的子串匹配(1.6 节),它确实包含 192.168.1.1 这段文字。再加上 -w(第二节),就只剩网关这一行:
1 | grep -Fw '192.168.1.1' hosts.txt |
1 | 192.168.1.1 gateway |
例二:查找带方括号的日志标签
日志中常见 [ERROR] 这样的标签:
1 | 10:01 [ERROR] disk full |
想找错误日志:
1 | grep '[ERROR]' app.log |
结果三行全部输出。原因是正则里的 [ERROR] 表示”E、R、O 中的任意一个字符”,INFO 里有 O,WARN 里有 R,都匹配上了。加上 -F 就只剩真正的错误行:
1 | grep -F '[ERROR]' app.log |
1 | 10:01 [ERROR] disk full |
什么时候用 -F: 要找的内容是一段固定文字,并且里面含有 .、[]、*、$ 等符号,比如 IP 地址、域名、版本号、日志标签、文件路径。用 -F 最省心,不用逐个去想哪些符号要转义。
推荐习惯用 -E
简单模式(只用 ^ $ . * [])在 BRE 和 ERE 中写法相同,加不加 -E 都行。差别在”或、一次或多次、可选、分组、次数”这几类功能上:BRE 要加反斜杠,ERE 直接写。
推荐 -E 的理由:
- 和编程语言一致。 ERE 的写法和 Python、JavaScript 等语言的正则相同,练出来的肌肉记忆可以通用。
- 更易读,少出错。 不用写一堆反斜杠。同样匹配 IP,BRE 要写
'\([0-9]\{1,3\}\.\)\{3\}[0-9]\{1,3\}',ERE 只需'([0-9]{1,3}\.){3}[0-9]{1,3}'。 - 可移植性更好。 BRE 的
\|、\+、\?是 GNU 扩展,换到其他 Unix 可能不支持;grep -E 'a|b'是 POSIX 标准写法。
唯一的代价: 用 -E 时,要搜字面上的 ( ) + ? | { } 需要加反斜杠转义,例如 grep -E 'main\('。整个模式都是纯文本时,直接用 -F。
五、显示上下文:-A、-B、-C
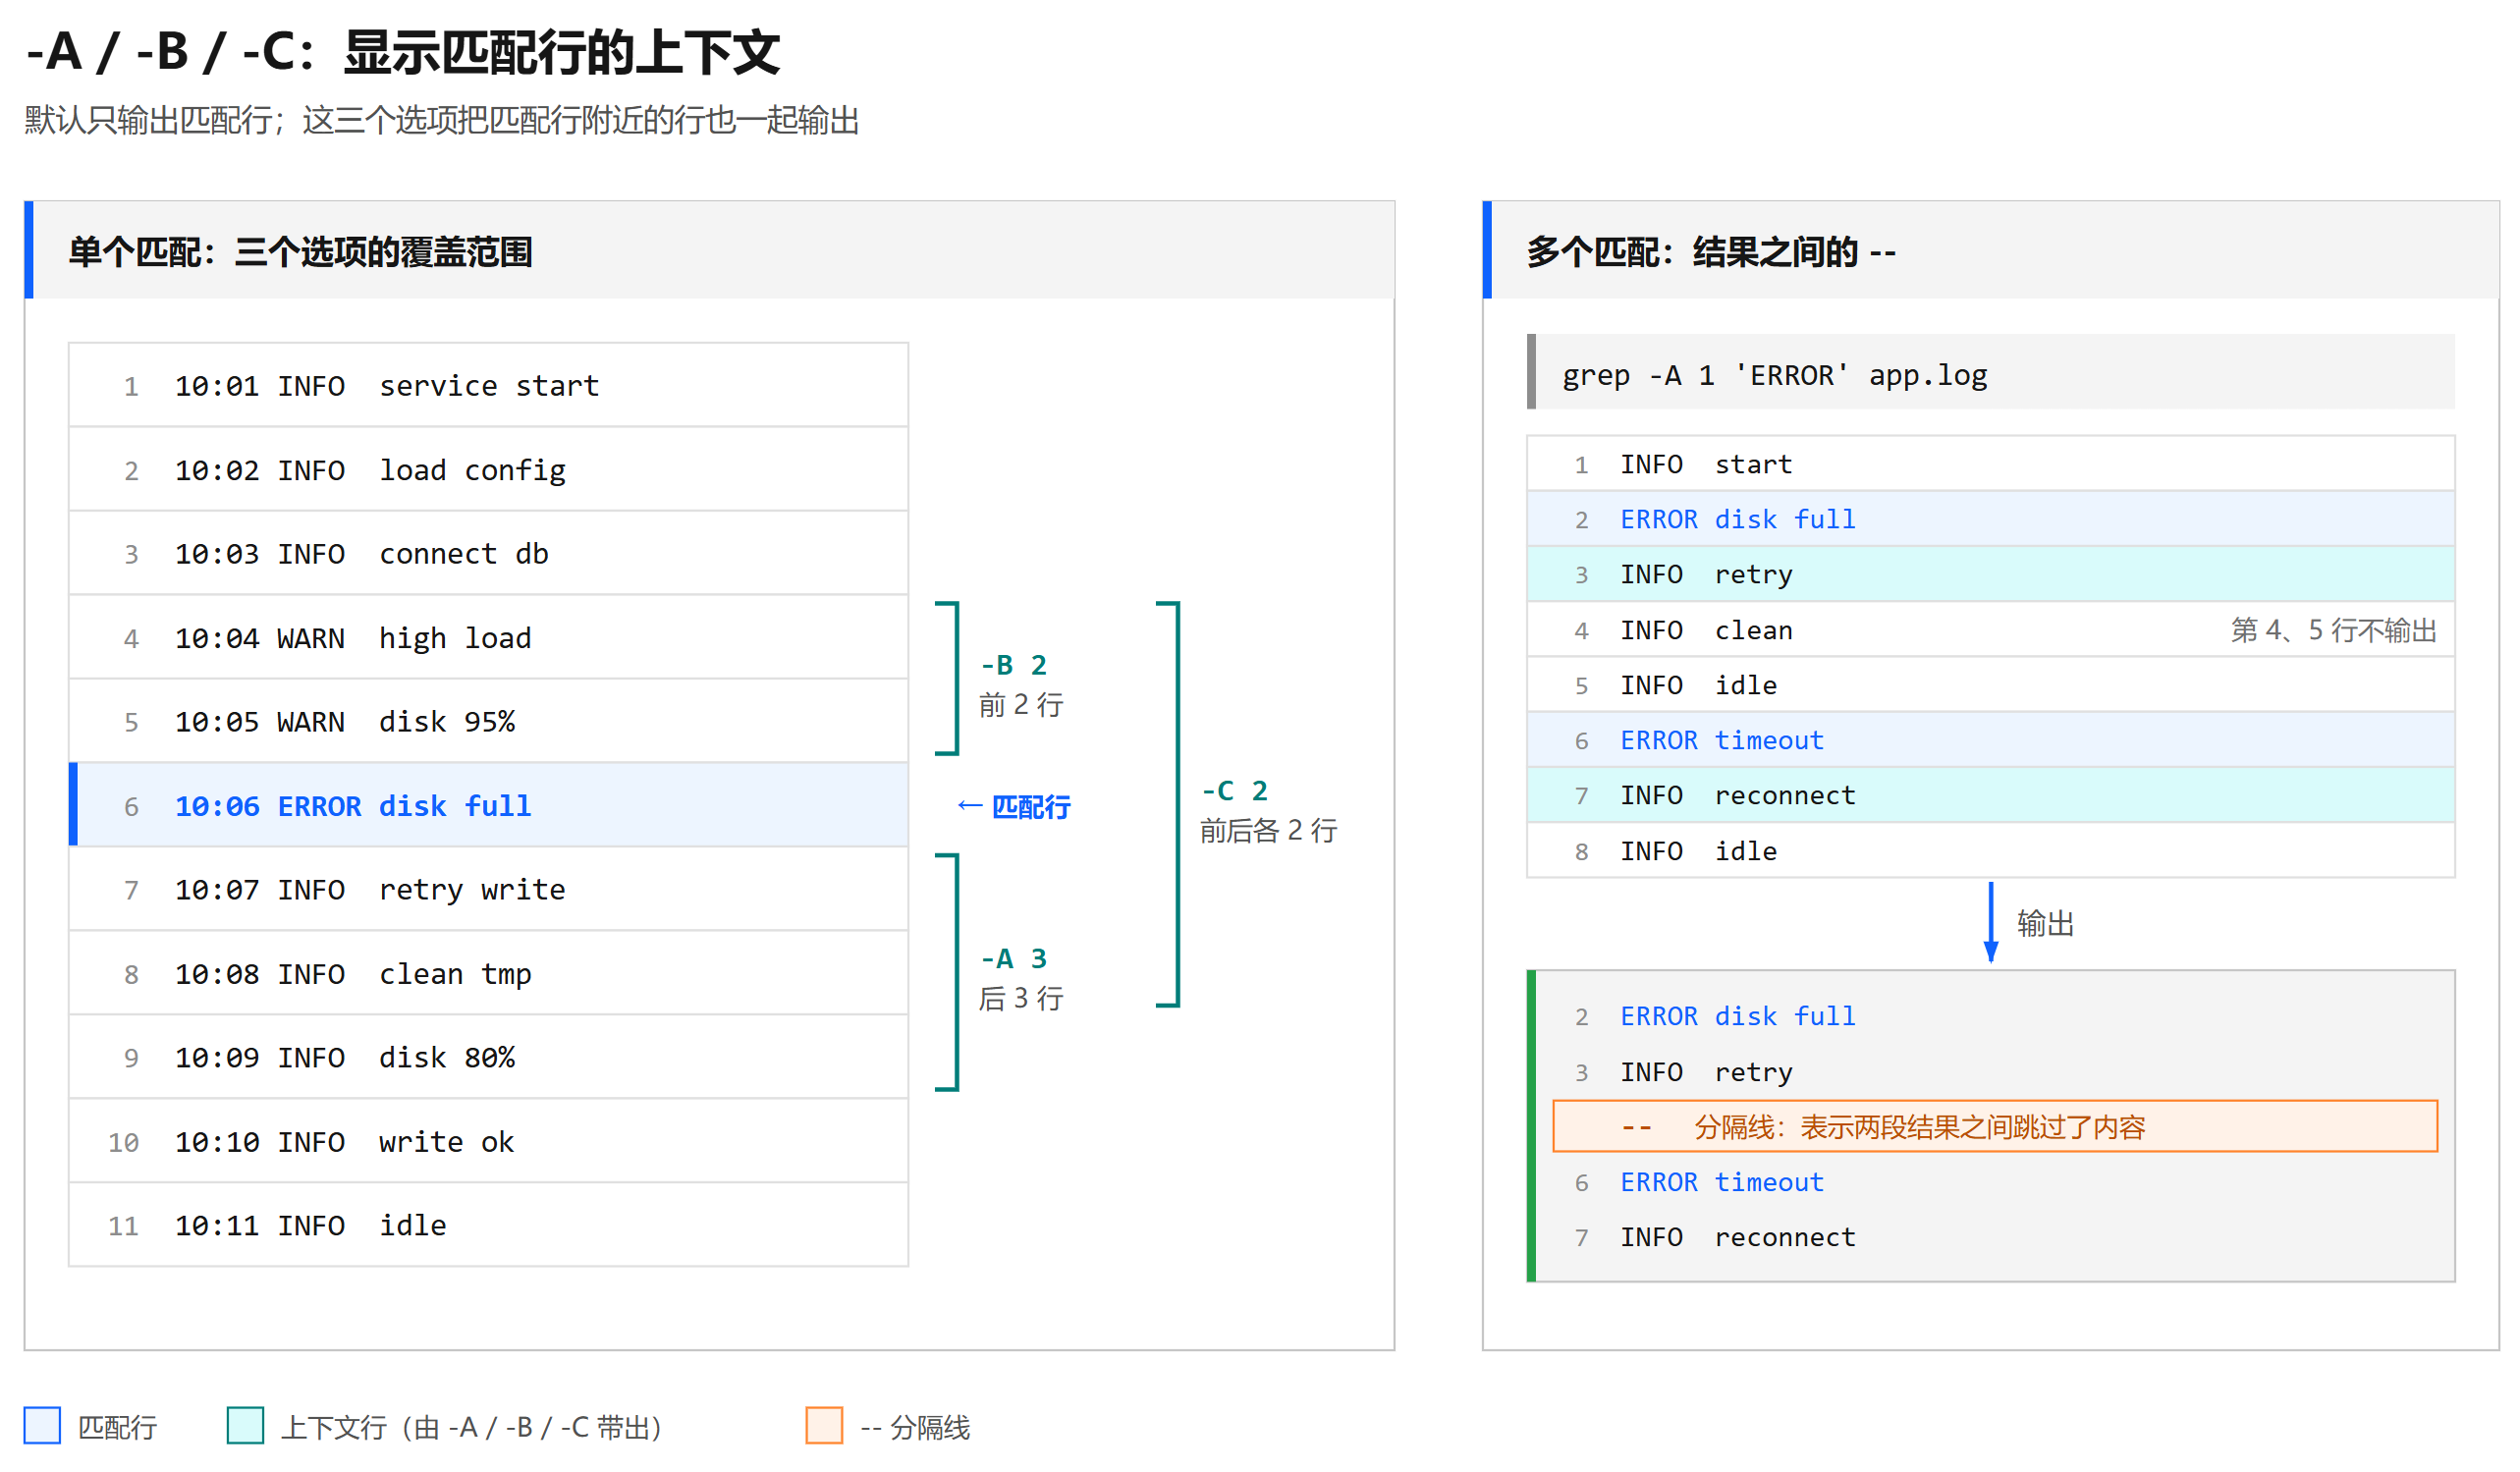
默认只输出匹配的那一行,这三个选项让 grep 把匹配行附近的行也一起输出。三个字母各管一个方向,记英文单词最不容易混:
| 选项 | 英文 | 含义 |
|---|---|---|
-A 3 |
After | 匹配行及其后 3 行 |
-B 3 |
Before | 匹配行及其前 3 行 |
-C 3 |
Context | 前后各 3 行 |
1 | grep -A 5 'Out of memory' /var/log/messages # 看 OOM 之后发生了什么 |
多段结果之间会出现 -- 分隔线,表示中间跳过了内容。-A 和 -B 可以同时用且数值不同,例如 -B 2 -A 10。
六、输出控制:-n、-c、-o、–color
-n:显示行号
改配置时最常用,找到行号后可以直接 vim +行号 文件 跳过去。
1 | grep -n 'PermitRootLogin' /etc/ssh/sshd_config |
-c:统计匹配的行数
1 | grep -c 'Failed password' /var/log/secure |
注意:-c 统计的是行数,一行里出现 3 次也只算 1(原因见 1.2 节)。
有个重要点不妨背下来:要按出现次数统计,用 grep -o ... | wc -l。
-o:只输出匹配到的部分(进阶)
默认输出整行,-o 只输出模式匹配到的那一段。它让 grep 从”找行”变成”提取内容”,也是检验正则写得对不对的最好工具:正则匹配到了什么,-o 一眼就能看出来,适合练正则。
1 | # 看正则到底匹配到了什么 |
初期可以先不刻意使用,等正则熟一些再用。
–color:高亮匹配内容
RHEL 和 Ubuntu 默认已通过别名开启(alias grep='grep --color=auto')。
注意在管道中间,auto 模式不会输出颜色;如需在 less 中看高亮,用 grep --color=always ... | less -R。
七、搜索目录:-r、-l、–include / –exclude
-r / -R:递归搜索
第一节说过,文件可以写多个。-r 更进一步:给它一个目录,grep 会自动把目录及子目录下的所有文件作为输入,输出格式为 文件名:内容。
1 | grep -r 'PermitRootLogin' /etc/ssh/ |
-r 不跟随符号链接,-R 会跟随。一般用 -r 即可,-R 遇到指向大目录的链接可能搜很久。
-l:只列出包含匹配的文件名
不关心内容,只想知道”哪些文件里有它”。典型场景是改主机名、IP 前先找出所有涉及的配置:
1 | grep -rl '192.168.1.10' /etc/ |
它和第三节里要搜的 -l 内容是两回事,这也是搜 - 开头的内容必须加 -e 或 -- 的原因。
–include / –exclude:按文件名筛选
场景: -r 会把目录下所有文件都搜一遍。但配置目录里常混着备份文件(.bak)、日志等,搜出来的结果会夹杂大量干扰。这时用下面三个选项,限定”只搜哪些文件”或”跳过哪些文件”:
bash
1 | grep -rn --include='*.conf' 'listen' /etc/nginx/ # 只搜 .conf 文件 |
注意:这里用的是 shell 通配符(* 表示任意内容),不是正则;匹配的是文件名,不是文件内容。
八、运维实战组合
选项可以合并写,grep -rni 等于 grep -r -n -i。以下组合在日常运维中最常见。
1 | # 1. 查看配置文件的有效内容(去掉注释行和空行) |
第 8 条的原理:[n]ginx 作为正则匹配的是 nginx,但 grep 自己的命令行里写的是 [n]ginx,不包含连续的 “nginx”,所以不会匹配到 grep 进程本身。比 | grep -v grep 少一个管道。
九、易错点与速查表
易错点
- grep 默认区分大小写,不区分要加
-i。 - 模式以
-开头时,必须用-e '-l'或grep -- '-l',否则会被当成选项。 -w的边界只看字母、数字、下划线:root-admin、/root仍然算整词匹配。- grep 用的是正则,不是 shell 通配符:”任意内容”写
.*,不是*。 - 正则里
.匹配任意字符,搜 IP、域名用-F。 - 模式不加单引号,可能被 shell 提前展开。
-c数的是行数,不是出现次数。- Ubuntu 24.04(grep 3.8 以后)使用
egrep/fgrep会出现警告,脚本里统一写grep -E/grep -F。
速查表
| 选项 | 作用 | 示例 |
|---|---|---|
-i |
忽略大小写 | grep -i error log |
-w |
整词匹配 | grep -w root /etc/passwd |
-x |
整行匹配 | grep -x 'nameserver 8.8.8.8' /etc/resolv.conf |
-v |
反向,显示不匹配的行 | grep -v '^#' /etc/fstab |
-e |
指定一个模式,可多次使用 | grep -e '-l' -e '-L' |
-f |
从文件读取模式 | grep -F -f iplist.txt access.log |
-E |
扩展正则(日常首选) | grep -E 'err|fail' |
-F |
纯文本,不解释正则 | grep -F 10.0.0.1 hosts |
-P |
Perl 正则 | grep -oP 'inet \K[\d.]+' |
-A N |
显示后 N 行 | grep -A 5 'OOM' messages |
-B N |
显示前 N 行 | grep -B 3 'segfault' messages |
-C N |
显示前后各 N 行 | grep -C 2 'Failed' secure |
-n |
显示行号 | grep -n Listen httpd.conf |
-c |
统计匹配行数 | grep -c Failed secure |
-o |
只输出匹配部分(进阶) | grep -oE '[0-9]+' |
-r / -R |
递归搜索目录 | grep -rn listen /etc/nginx/ |
-l |
只列出含匹配的文件名 | grep -rl 10.0.0.1 /etc/ |
--include |
只搜指定文件名(通配符) | --include='*.conf' |
--exclude / --exclude-dir |
排除文件 / 目录 | --exclude-dir=.git |